01Was ist prädiktives A/B-Testing?
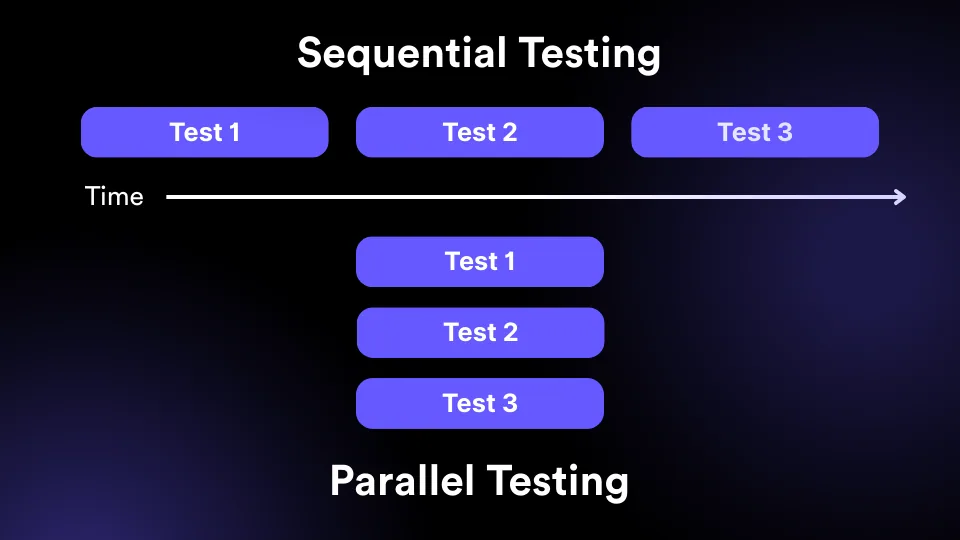
Fangen wir mit der Verwirrung an. Sie ist der Grund, warum es diese Seite gibt. Wenn ein Anbieter „prädiktiv“ sagt, frag, wann die Vorhersage passiert. Bevor der Test gebaut ist oder während er läuft? Davon hängt ab, was dir die Funktion bringt. Und die meisten Anbieter sagen das nicht klar dazu.
| Mechanismus | Wann er greift | Was er verändert |
|---|---|---|
| Automatische Traffic-Zuteilung, meist ein Multi-Armed Bandit | Während der Test läuft | Wie der Traffic auf bestehende Varianten verteilt wird |
| Sequenzieller oder vorzeitiger Abbruch | Während der Test läuft | Wann der Test endet |
| Bewertung der Idee vor dem Start, gegen ein Testgedächtnis | Bevor der Test gebaut ist | Welche Tests überhaupt gebaut werden |
Die ersten beiden verbessern einen Test, für den du dich schon entschieden hast. Der dritte entscheidet, ob du ihn überhaupt fährst. Wenn nur etwa jeder fünfte Test einen echten Gewinner bringt, setzt der dritte Mechanismus am viel größeren Verlust an. Der ist größer als bei den anderen beiden zusammen. Denn alles, was in die vier verlorenen Tests geflossen ist, ist schon ausgegeben, bevor Zuteilung oder Abbruch überhaupt mitreden können.
02Wie unterscheidet sich das von einem Multi-Armed Bandit?
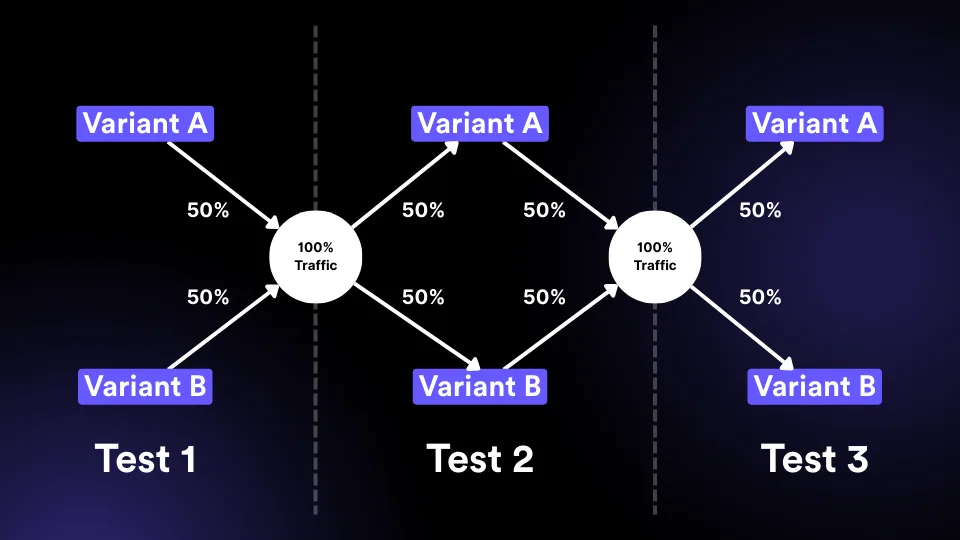
Bandits verdienen eine faire Beschreibung. In ihrem Job sind sie wirklich gut. Ein Bandit schiebt Traffic zu den Varianten, die gewinnen, während die Daten reinkommen. So senkt er den Regret. Gemeint sind die Kosten dafür, dass Leute während der Lernphase die schlechtere Version sehen. Thompson Sampling ist in Testing-Plattformen inzwischen der gängigste Ansatz. Es balanciert Exploration und Exploitation aus, ohne dass jemand einen Parameter von Hand setzen muss.
Den Haken lassen Anbieter meist weg. Jeder Bandit-Algorithmus tauscht statistische Sicherheit darüber, welche Variante die beste ist, gegen bessere Ergebnisse während der Testphase. Das ist ein sehr guter Tausch, wenn Testphase und Einsatzphase dasselbe sind. Zum Beispiel bei einer Aktion, die am Montag endet, bei einem Empfehlungssystem, das laufend optimiert, oder bei einer Vorauswahl aus vielen Kreativvarianten. Es ist ein schlechter Tausch, wenn ein Gewinner ein Jahr lang live bleibt. Dann ist das Testfenster nur ein kleiner Teil der Zeit, in der der Gewinner Wert bringt. Und ein falsch gewählter Gewinner kostet dich deutlich mehr, als du an Traffic gespart hast.
Die beiden Mechanismen konkurrieren also nicht. Ein Bandit beantwortet, wie du Traffic auf bestehende Varianten verteilst. Die Bewertung vor dem Start beantwortet, welche Varianten es überhaupt geben sollte. Ein Programm kann beides sinnvoll nutzen. Die meisten holen aber mehr aus dem zweiten, weil dort der größere Verlust liegt.
03Warum lässt sich ein Testergebnis überhaupt vorhersagen?
Der Mechanismus ist unspektakulär. Das ist ein gutes Zeichen. Testing-Wissen lässt sich nicht auf einzelne Elemente übertragen. Auf die Art der Änderung plus Kontext aber schon. An dieser Unterscheidung hängt das ganze Argument. Und du siehst sie erst, wenn du sehr viele dokumentierte Ergebnisse hast.
- Die Art der Änderung zählt, nicht das Element. Kaufentscheidungen auf der Produktseite leichter machen hat eine Erfolgsbilanz. Den Button grün machen hat keine und wird nie eine haben. Dasselbe Element gewinnt in einem Shop und verliert im nächsten.
- Der Kontext entscheidet über die Richtung. Dieselbe Änderung wirkt oft genau andersherum. Es kommt darauf an, ob du teure Produkte mit langer Bedenkzeit verkaufst oder Impulsartikel. Ergebnisse aus vergleichbaren Shops enthalten diese Information. Ein Hypothesen-Dokument nicht.
- Die Größenordnung ist Voraussetzung, keine Angeberei. Ein Shop mit zwei Tests pro Monat kommt auf ein paar Dutzend Ergebnisse im Jahr. Die meisten davon gehen unentschieden aus. Das reicht für keine einzige Basisrate. Lernen muss man über viele Shops hinweg.
Genau deshalb sind Daten aus vielen Shops die Zutat, die schwer zu bekommen ist. Und deshalb bieten die meisten Plattformen diese Funktion nicht an. Ihre KI-Funktionen laufen auf deinem Traffic und deinen Ergebnissen. Sie können Muster in deinem eigenen Shop sichtbar machen. Sie können dir aber nicht sagen, was passiert ist, als dieselbe Änderung in vergleichbaren Shops lief. Das liegt am fehlenden Datenzugang, nicht am Modell. Kein besserer Algorithmus ändert daran etwas.
04Was kann dir eine Prognose nicht sagen?
Wer ehrlich über diese Kategorie redet, fängt mit den Grenzen an. Hier sind sie als Liste. Damit kannst du jeden Anbieter prüfen, uns eingeschlossen.
- Eine Vorannahme ist kein Ergebnis. Eine Prognose sortiert dein Backlog neu. Den Test fahren musst du trotzdem. Und du musst ihn mit einer gültigen Abbruchregel sauber auswerten.
- Dein eigener Kontext zählt weiter. Dein Sortiment, deine Margen, deine Zielgruppe und deine Markenregeln stehen in keinen Daten aus anderen Shops. Eine hoch bewertete Idee, die deiner Marke schadet, bleibt eine schlechte Idee.
- Neue Ideen haben keine Vorgeschichte. Was wirklich neu ist, gilt als unbekannt, nicht als schlecht. Wer nur hoch bewertete Ideen testet, lernt mit der Zeit nichts Neues mehr. Halte einen Teil deiner Kapazität für Exploration frei.
- Eine Prognose repariert keine schlechte Umsetzung. Ein gut gewählter Test kann im mobilen Browser kaputtgehen, das falsche Event tracken oder an Tag neun abgebrochen werden, weil die Zahlen an Tag neun gut aussahen. Dann bringt er genauso wenig wie ein schlecht gewählter.
- Gesamtzahlen verdecken Effekte in einzelnen Segmenten. Eine Art von Änderung kann insgesamt nichts bewirken und in einem Traffic-Segment trotzdem stark positiv sein. Ein Score fasst zusammen. Und beim Zusammenfassen geht immer Detail verloren.
05Warum bringt Aussortieren mehr als mehr Tests?
Hier die Rechnung in Worten. Sie entscheidet, ob dir diese Kategorie etwas bringt. Nimm ein Programm mit einer festen Zahl Tests pro Quartal. Es liegt beim Branchenmuster: etwa ein Gewinner in fünf Tests. Dann gehen vier Fünftel der Designstunden, Entwicklerstunden, QA-Zeit und des Test-Traffics in Tests ohne Gewinner. Dieser Verlust steckt im System. Mit einem schlechten Team hat er nichts zu tun.
Jetzt die zwei Hebel, die du hast. Doppeltes Tempo verdoppelt die Gewinner, aber auch den Verlust. Und es braucht ungefähr doppelt so viel Traffic und ein doppelt so großes Team. Bessere Auswahl lässt die Kosten, wo sie sind. Sie ändert, wie viel davon bei Gewinnern landet. Ist dein Traffic begrenzt, ist der zweite Hebel klar besser. Ist dein Team begrenzt, ist er der einzige, den du überhaupt hast.
Sieh unsere Zahlen als Bilanz unseres Programms, nicht als Prognose für deinen Shop. Sie stammen aus über 4.000 Tests für über 250 E-Commerce-Marken. Das ist eine echte Bilanz. Ein Versprechen ist es trotzdem nicht. Jeder Anbieter, der seine eigene Gewinnquote in deine erwartete Gewinnquote umrechnet, will dir etwas verkaufen.
06Wie sieht prädiktives A/B-Testing in einem echten Produkt aus?
Wir sind hier der Anbieter. Das Nützlichste, was wir dir zeigen können, ist also der Mechanismus und nicht der Pitch. Apex hat drei Ebenen. Nur die erste ist ungewöhnlich.
- Testgedächtnis: 4,3 Millionen Tests aus 151.000 Shops, gesammelt über acht Jahre. Es bewertet jede Testidee vor dem Start. So ist dein Backlog nach Evidenz sortiert und nicht nach Begeisterung.
- Testing-Tool: A/B-Tests direkt im Shop bauen, starten und auswerten. Prognose und Umsetzung liegen am selben Ort. Deshalb wird die Prognose jedes Mal am Ergebnis geprüft.
- Begleitete Umsetzung: Deine Tests werden gemeinsam mit dem DRIP-Team gebaut, per QA geprüft, gestartet und ausgewertet. So scheitert kein gut gewählter Test an einer kaputten Variante oder einem zu frühen Abbruch.
Auf den geschlossenen Kreislauf in der zweiten Ebene würden wir bei jedem Produkt dieser Kategorie achten. Bei unserem genauso wie bei allen anderen. Eine Prognose, die nie mit dem Ergebnis verglichen wird, kann nicht besser werden. Prüfen lässt sie sich auch nicht. Bewertet ein Anbieter deine Ideen, aber die Scores liegen in einem anderen System als die Ergebnisse? Dann frag ihn, woher er weiß, dass seine Scores etwas taugen.
Der Vollständigkeit halber noch zwei Dinge, die Apex nicht ist. Apex ist keine Personalisierungs-Engine und hat keine Personalisierungsfunktion veröffentlicht. Und es gibt keine öffentlichen Preise. Apex wird mit begleiteter Umsetzung verkauft, und den Umfang legen wir im Gespräch fest.
07Wie prüfst du die Prognose-Aussage eines Anbieters?
Das gilt auch für uns. Genau diese Fragen wünschen wir uns von Käufern. Kann ein Anbieter sie nicht klar beantworten, hat er meistens nur eine bestehende Funktion umbenannt.
- Wann passiert die Prognose? Bevor die Variante gebaut ist oder während der Test läuft? Nur das Erste ändert, was du testest.
- Aus welchen Daten wird sie berechnet? Aus deinem Traffic und deinen Ergebnissen oder aus dokumentierten Ergebnissen vieler Shops? Aus deinen eigenen Daten erfährst du nicht, was anderswo passiert ist.
- Ist der Kreislauf geschlossen? Werden Prognosen mit echten Ergebnissen verglichen? Und siehst du diesen Vergleich für deine eigenen Tests?
- Welche Grenzen nennt der Anbieter? Eine echte Methode hat eine ganze Liste. Unsere fängt so an: Eine Prognose ist eine Vorannahme, keine Garantie.
- Berührt die Funktion die Abbruchregel? Wenn ein prädiktives Signal Tests früher beendet, ist das ein Statistikproblem mit Produktnamen.
Was heißt das jetzt für die Kategorie? Prognose ist keine Magie und kein Ersatz für Testing. Sie hilft dir, ein begrenztes Traffic-Budget auf die Ideen zu setzen, die es am ehesten zurückzahlen. Bei einer Basisrate von etwa einem Gewinner in fünf Tests ist das für die meisten Shops die größte einzelne Verbesserung, die sie machen können.
Dein aktuelles Backlog bewerten lassen, bevor du etwas baust? Prüfen, ob dein Shop passt→