Ob Testing dir Geld bringt, ist einfache Mathematik:
Wachstum = Testqualität × Testrate × Gewinnrate
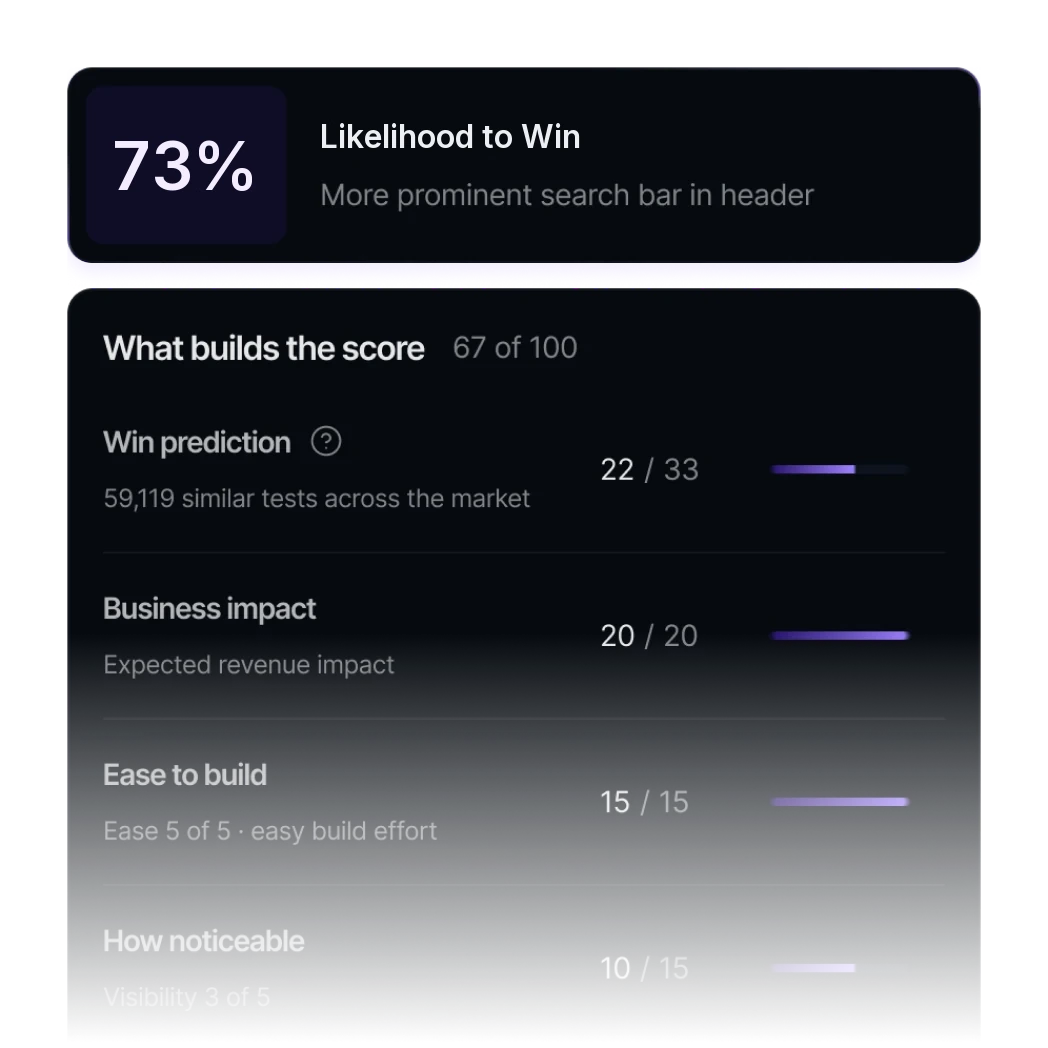
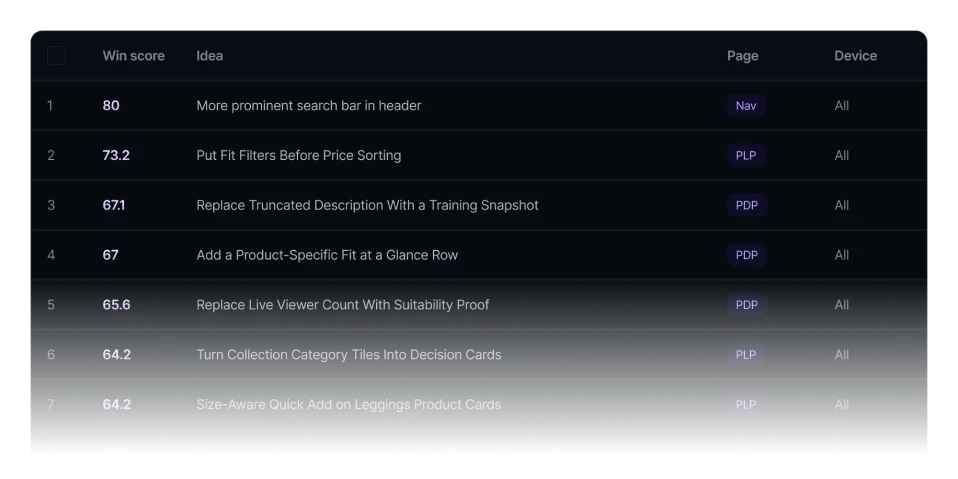
Bei der Testqualität hakt es zuerst. Deine nächste Testidee ist fast nie neu. Jemand hat sie schon in einem Shop wie deinem getestet. Du weißt nur nicht, wie es ausging. Brainstormings und Best-Practice-Listen heißen: Du setzt vier Wochen Traffic auf Ideen, die nie jemand geprüft hat.
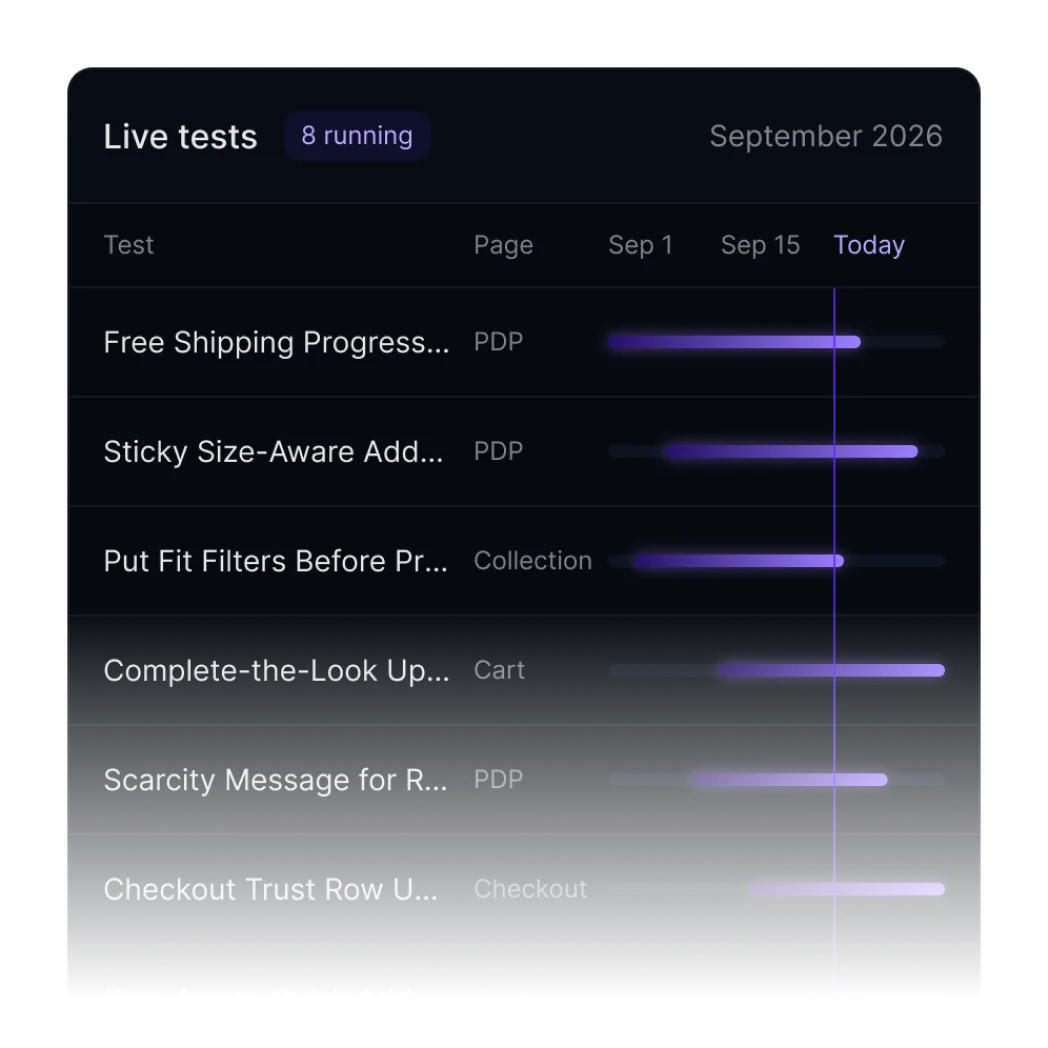
Bei der Testrate hakt es leise. Die meisten Shops fahren einen Test nach dem anderen. Sie haben Angst, dass sich parallele Tests gegenseitig verfälschen. Tatsächlich ändert das in etwa einem von 50.000 Fällen eine Entscheidung (Microsoft hat das geprüft, und Booking.com fährt über 1.000 Tests gleichzeitig). Mit zwölf Tests im Jahr lernst du langsamer, als sich der Markt bewegt.
Bei der Gewinnrate hakt es zuletzt, und das tut am meisten weh. Wer rät, gewinnt in der Branche etwa 1 von 5 Tests. Und manche dieser „Gewinne“ sind gar keine: zu früh ausgerufen, bei zu wenig Konfidenz, dann live genommen. Ab da kosten sie dich still und dauerhaft Geld.
Multiplizier drei schwache Zahlen, und du hast, was die meisten Shops haben: ein Programm, das mehr kostet, als es bringt. Deshalb sind die meisten Programme nach spätestens vier Monaten tot.
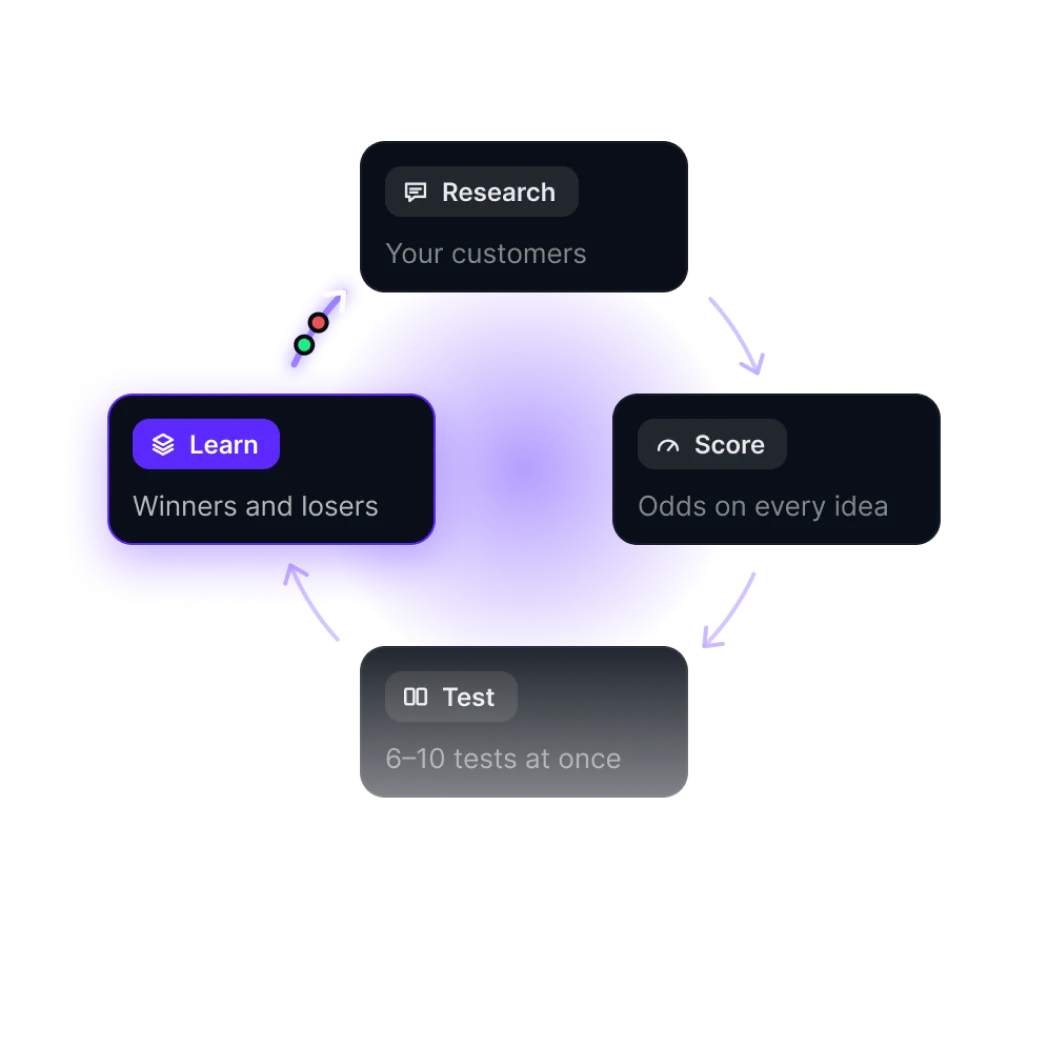
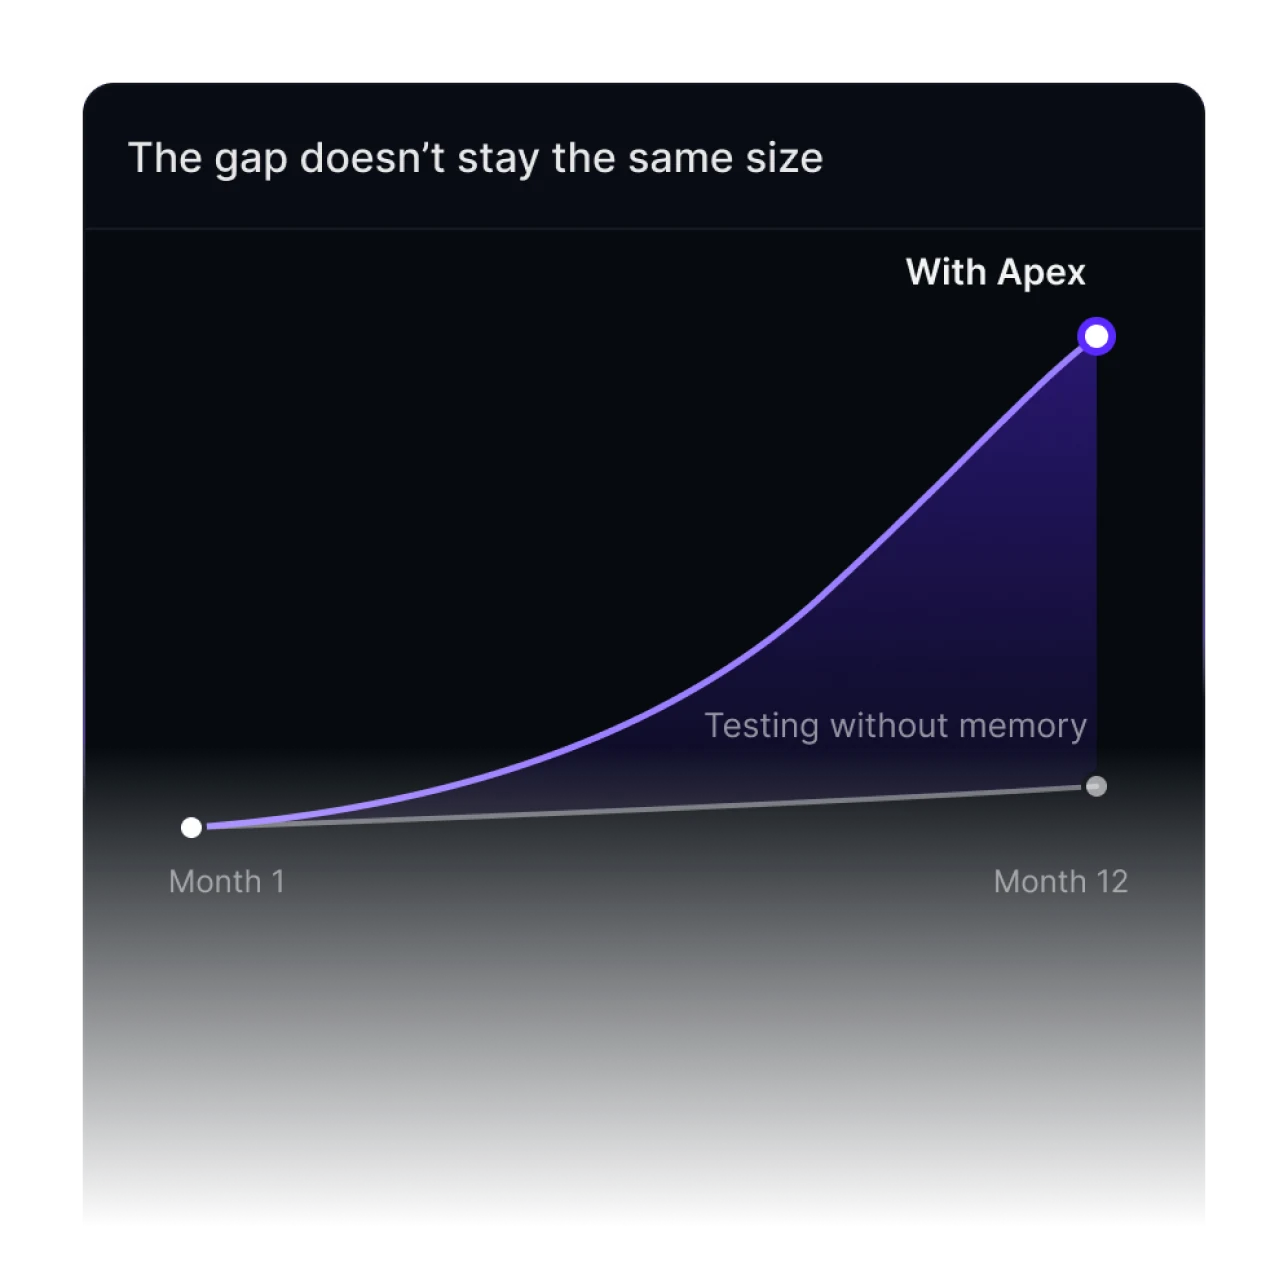
Die Multiplikation funktioniert aber auch andersherum. Bewegst du alle drei Hebel gleichzeitig, wachsen die Uplifts mit Zinseszins: Kleine Gewinne jeden Monat summieren sich in sechs Monaten zu zweistelligem Wachstum. Das schafft kein einzelner Test, egal wie gut er ist (Wharton hat 252 Unternehmen untersucht: Einzelne Tests bewegen den Umsatz selten auch nur um 2 %).
Prediction-Based Experimentation ist dafür gebaut, alle drei gleichzeitig zu bewegen. So funktioniert sie, Hebel für Hebel.