01Wie solltest du A/B-Testing-Software vergleichen?
Jeder A/B-Testing-Vergleich, den du findest, sieht gleich aus: Tools gegen Features, dazu Häkchen. Das Format taugt nichts mehr, seit jeder Anbieter denselben Funktionsumfang hat. Visueller Editor, Zielgruppen-Targeting, eigene Ziele, Segment-Reports, multivariates Testing, Integrationen: Heute ist fast alles grün abgehakt. Welches Tool dein Programm wirklich zum Laufen bringt, verrät dir das nicht.
Mit diesen Dimensionen arbeiten wir selbst, wenn ein Kunde uns bei der Toolauswahl um Hilfe bittet. Sie sind danach sortiert, wie oft sie am Ende den Ausschlag geben. Die fünfte kam dazu, nachdem unsere eigene Gewinnquote von 27 % (2024) auf 55 % im letzten Quartal gestiegen ist. Das Tool haben wir dafür nicht gewechselt.
- Statistik-Engine: frequentistisch, bayesianisch oder nicht dokumentiert. Sie entscheidet, wie lange ein Test läuft und wann du hinschauen darfst. Und wie oft das Tool einen Test ohne echten Effekt zum Gewinner erklärt.
- Datenhoheit und Standort: Wer verarbeitet die Besucherdaten, und nach welchem Recht? Bringt das Tool eigenes Tracking mit, oder liest es aus deinem Analytics? An dieser Dimension kann deine Rechtsabteilung die Auswahl kippen.
- Editor-Modell: visuell, Code-First oder serverseitig. Es geht nicht darum, was besser ist. Es geht darum, was zu den Leuten passt, die im nächsten Quartal wirklich die Varianten bauen.
- Preismodell: Pauschale, Traffic-Stufen, Visitor Credits, pro Impression, selbst gehostet oder auf Anfrage. Der Einstiegspreis ist Marketing. Was du wirklich zahlst, bestimmt das Modell.
- Testauswahl: Hilft dir das Produkt bei der Entscheidung, welche Tests laufen sollen? Fast kein Tool kann das. Genau dort gewinnt oder verliert ein Testing-Programm das meiste Geld.
02Welche Statistik-Engine nutzt das Tool, und ändert das deine Entscheidungen?
Die Statistik-Engine ist der unsichtbarste Teil eines Testing-Tools. Trotzdem entscheidet sie, ob deine Ergebnisse echt sind. Am Markt gibt es zwei Familien, und jede scheitert auf ihre eigene Art.
Eine frequentistische Engine verlangt, dass du die Stichprobengröße vor dem Start berechnest. Das Ergebnis bewertest du erst, wenn diese Stichprobe erreicht ist. Das ist streng, manchmal unbequem und schwer auszutricksen. Eine bayesianische Engine zeigt dir laufend, wie wahrscheinlich eine Variante das Original schlägt. SmartStats von VWO ist das klarste Beispiel in dieser Liste. Für Nicht-Statistiker ist das tatsächlich leichter zu lesen. GrowthBook kann beides und lässt das Team wählen.
Wir arbeiten bei DRIP frequentistisch. Der Grund liegt im Verhalten, nicht in der Mathematik. Eine Wahrscheinlichkeit, die sich ständig aktualisiert, verführt zur teuersten Angewohnheit im E-Commerce-Testing: den Test an dem Tag zu stoppen, an dem die Zahlen gut aussehen. Mit einer vorab berechneten Stichprobengröße ist so ein Abbruch klar ein Regelbruch. Keine Entscheidung. Beide Engines lassen sich richtig nutzen. Nur eine ist schwer zu missbrauchen.
Diese Fragen solltest du zur Engine stellen
- Ist die Engine frequentistisch, bayesianisch oder eine sequenzielle Variante? Und ist das öffentlich dokumentiert?
- Berechnet das Tool vor dem Start, wie groß die Stichprobe sein muss?
- Was zeigt die Oberfläche an Tag drei? Und warnt sie dich, schon danach zu handeln?
- Wie geht das Tool mit mehreren Metriken um? Korrigiert es, wenn du viele Ziele misst?
- Können wir die Rohdaten zu Zuweisung und Conversions exportieren und ein Ergebnis selbst prüfen?
Die letzte Frage ist wichtiger, als sie aussieht. Ein Tool mit Rohdaten-Export kannst du prüfen. Ein Tool, das nur sein eigenes Urteil zeigt, nicht. Dann kaufst du mit der Software auch das statistische Urteil des Anbieters.
03Wo liegen deine Testdaten, und wem gehören sie?
Für einen europäischen Online-Shop kann diese Dimension die Auswahl in einem einzigen Meeting entscheiden. Sie hat drei Ebenen. Die meisten Anbieter beantworten nur die erste.
- Verarbeitungsort: Wo werden Besucherdaten gespeichert und verarbeitet? ABlyft nutzt deutsche Server. Kameleoon und AB Tasty laufen auf europäischer Infrastruktur. VWO bietet ein EU-Rechenzentrum als Option an, nicht als Standard. Optimizely sitzt in den USA und arbeitet mit Standardvertragsklauseln und einem Auftragsverarbeitungsvertrag.
- Eigenes Tracking oder dein Analytics: Die meisten Tools setzen eigene Kennungen und zählen Conversions selbst. Varify.io macht das bewusst nicht und liest die Ergebnisse aus Google Analytics 4, Matomo oder Piwik Pro. GrowthBook liest direkt aus deinem Data Warehouse, egal ob BigQuery, Snowflake, Postgres oder ClickHouse.
- Architektur oder Konfiguration: Ist ein Tool durch seine Architektur konform, kannst du es gar nicht falsch einstellen. Ist es nur durch die Konfiguration konform, liegt die Verantwortung bei deinem Team. Und dein Team ändert sich mit der Zeit.
Eine Folge fürs Geschäft erwähnen Rechtsabteilungen selten. Ein Tool, das erst nach Zustimmung laden darf, sieht nur den Teil deines Traffics, der zustimmt. Wer ablehnt, ist für den Test unsichtbar. Deine Stichprobe schrumpft, und der Test dauert länger. Cookielose und serverseitige Architekturen umgehen das. In einem Shop mit wenig Traffic entscheidet dieser Unterschied, wie viele Entscheidungen du pro Jahr treffen kannst.
04Passt das Editor-Modell zum Team, das die Tests baut?
Meistens lautet die Editor-Frage: „Welcher Editor ist der beste?“ Die bessere Frage: Wer baut die nächsten zwanzig Varianten? Und was passiert mit deinem Programm, wenn diese Person keine Zeit hat?
| Modell | Wer damit arbeitet | Der Kompromiss |
|---|---|---|
| visuell, auf der Seite | Marketing und CRO-Spezialisten, sobald das Snippet einmal eingebaut ist | schnell beim ersten Test, aber schwereres Script und Grenzen bei tiefen DOM-Änderungen |
| Code-First | Frontend-Entwickler | unbegrenzte Flexibilität und minimales Seitengewicht, kostet aber Entwicklerzeit |
| serverseitig | Backend-Entwickler | testet auch Preise, Logik und Headless-Frontends, aber ohne visuelle Abkürzung |
| begleitete Umsetzung | ein externes Team, mit deiner Freigabe | nimmt dir das Risiko bei QA und Analyse ab, kostet mehr als Self-Service |
Zwei Fehler sehen wir immer wieder. Ein Marketing-Team kauft ein Code-First-Tool, weil es bei der Performance gut abschneidet. Danach laufen vier Tests im Jahr, weil jede Variante bei den Entwicklern in der Warteschlange hängt. Ein Entwicklerteam kauft einen visuellen Editor und umgeht ihn bei jedem nicht trivialen Test. Das Script lädt der Shop trotzdem, ganz ohne Nutzen. Beides vermeidest du mit einer Frage vor der Demo: Wer baut Variante B?
Auch das Seitengewicht gehört in diese Dimension, denn das Editor-Modell bestimmt es weitgehend. ABlyft hält sein clientseitiges Script unter 5 KB. Der Editor läuft als Chrome-Erweiterung, also lädt dein Shop keine Editor-Runtime. VWO, Kameleoon und AB Tasty liegen bei 30 bis 40 KB, weil sie Editor und Verhaltensanalyse in den Browser laden. Das clientseitige Snippet von Optimizely ist mit rund 80 KB das schwerste in diesem Vergleich. Wenn Core Web Vitals in deinem Shop schon die Rankings beeinflussen, zahlst du für diesen Komfort einen echten Preis.
05Wie schneiden die großen A/B-Testing-Tools in diesen Dimensionen ab?
Steht unten in einer Zelle „nicht öffentlich dokumentiert“, haben wir die Lücke nicht mit einer Vermutung gefüllt. Eine leere Zelle ist eine Frage an den Anbieter. Wie er sie beantwortet, gehört zur Bewertung.
| Tool | Statistik-Engine | Datenverarbeitung | Editor-Modell | Preismodell |
|---|---|---|---|---|
| Apex by DRIP | frequentistisch, Fixed-Horizon mit Holm-Bonferroni-Korrektur und SRM-Gate, optional Always-Valid-Sequenzanalyse (mSPRT) | UK (London) und Irland, eine First-Party-Besucher-ID, kein Fingerprinting, keine IP-Speicherung | Testing-Tool im Shop plus begleitete Umsetzung | Gespräch buchen |
| ABlyft | nicht öffentlich dokumentiert | deutsche Server, cookielos als Standard | Code-First, visueller Editor als Chrome-Erweiterung | Traffic-Stufen ab 79 €/Monat, kostenloser Plan |
| Varify.io | liest Ergebnisse aus deinem Analytics | deutsches Unternehmen, EU-Hosting, kein eigenes Tracking | visuell, auf der Seite | Pauschale, 149 € oder 249 €/Monat |
| VWO | bayesianisch (SmartStats) | EU-Rechenzentrum als Option verfügbar | visuell, plus serverseitig über FME | Traffic-Stufen, 139 $ bis 775 $/Monat, kostenlose Version |
| Kameleoon | nicht öffentlich dokumentiert | aus Frankreich, Verarbeitung in der EU, an der CNIL ausgerichtet | visuell, plus mehr als zehn serverseitige SDKs | auf Anfrage, Marktdaten 25.000 € bis 50.000 €/Jahr |
| AB Tasty | nicht öffentlich dokumentiert | europäische Infrastruktur, ISO 27001 | visuell (der stärkste hier), plus Flagship-SDKs | Visitor Credits ab rund 15.000 €/Jahr |
| Optimizely | Multi-armed Bandits verfügbar | Hauptsitz USA, Standardvertragsklauseln und AVV, SOC 2 Type II | visuell, plus Full-Stack und Edge | pro Impression, typisch 36.000 $+/Jahr |
| GrowthBook | frequentistisch oder bayesianisch, deine Wahl | selbst gehostet, kein externer Auftragsverarbeiter | Code-First, kein visueller Editor | selbst gehostet kostenlos, Cloud ab 99 $/Monat |
Lies die Preisspalte als Prognose, nicht als Preis. Pauschale heißt: Mehr Traffic kostet dich nichts extra. Traffic-Stufen steigen planbar, wenn du deine Sessions kennst. Visitor Credits rechnen nach Verbrauch ab. Das ist besser planbar als reine Traffic-Preise, bei viel Volumen aber teuer. Pro Impression heißt: Eine virale Woche schlägt direkt auf deine Rechnung durch. Selbst gehostet bleibt die Lizenz flach, dafür zahlst du mit Engineering-Zeit. Preise auf Anfrage, unsere eingeschlossen, heißen: Ohne Gespräch kannst du nicht vergleichen. Das ist eine echte Hürde.
06Welche Dimension fehlt in Vergleichstabellen?
Die ersten vier Dimensionen messen alle die Ausführung: wie Ergebnisse berechnet werden, wohin die Daten gehen, wer eine Variante bauen kann, was der Betrieb kostet. Keine davon stellt die Frage, die über die Rendite des ganzen Programms entscheidet: War der Test den Aufwand überhaupt wert?
Die Rechnung ist hart. Branchenweit gewinnt etwa jeder fünfte Test. Die anderen vier kosten trotzdem Designzeit, Entwicklerzeit, QA und zwei bis vier Wochen Traffic. Und zwar auf einer Seite, die du in der Zeit auch hättest verbessern können. Ein besserer Editor macht diese Zyklen schneller. Weniger werden sie dadurch nicht.
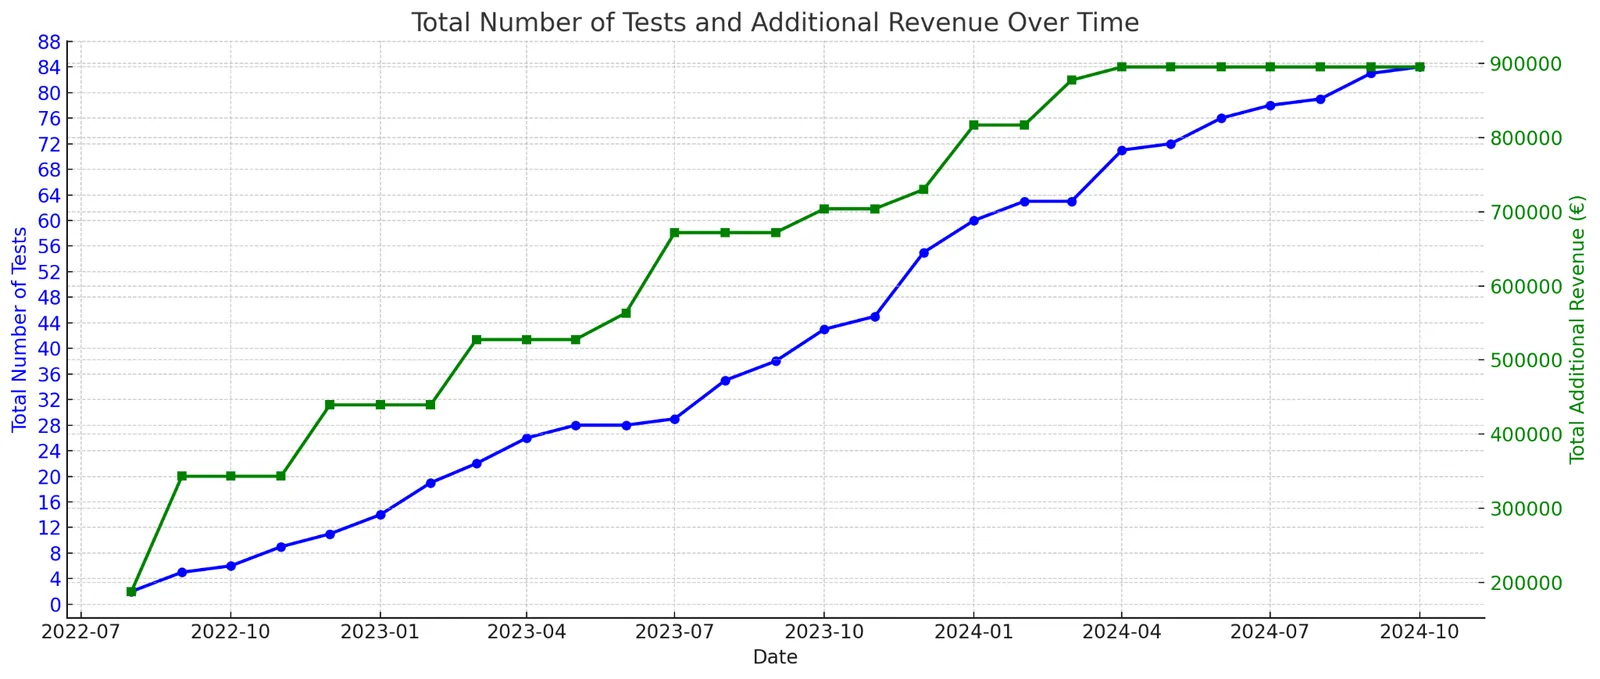
Das zeigen nur viele Tests. Deshalb hier unsere eigene Bilanz. DRIP hat mehr als 4.000 Tests für über 250 E-Commerce-Marken gefahren. 2024 lag unsere Gewinnquote bei 27 %. Im letzten Quartal lag sie bei 55 %. Wir haben weder das Testing-Tool gewechselt noch unser Testvolumen verdoppelt. Die Verbesserung kam von den Ideen, die wir abgelehnt haben, bevor jemand sie gebaut hat. Und das verlässliche Signal war nie das Element, das wir verändert haben.
- Die Art der Änderung zählt, nicht das Element: Für „die Kaufentscheidung auf der Produktseite leichter machen“ gibt es ein klares Muster in den Daten. Für „den Button grün machen“ gibt es keins, und es wird auch nie eins geben. Dasselbe Element gewinnt in einem Shop und verliert im nächsten.
- Der Kontext entscheidet über die Richtung: Eine Änderung, die bei teuren, gut überlegten Käufen gewinnt, verliert oft bei Impulskäufen. Und umgekehrt. Frühere Ergebnisse aus ähnlichen Shops kennen diesen Unterschied. Ein Hypothesen-Dokument kennt ihn nicht.
- Das beste Ergebnis ist eine Ablehnung: Das Wertvollste, was dir ein Testgedächtnis liefert, ist die Liste der Ideen, die du nicht startest. Niemand feiert sie. Aber genau dort entsteht die Gewinnquote.
Wie Apex in dieses Framework passt
Apex ist unsere A/B-Testing-Plattform für Online-Shops. Wir haben sie allein für diese fünfte Dimension gebaut. Sie hat drei Ebenen. Das Testgedächtnis kennt 4,3 Millionen Tests aus 151.000 Shops, gesammelt über acht Jahre, und bewertet jede Idee vor dem Start. Es basiert auf unserer eigenen A/B-Test-Datenbank, einer der größten im E-Commerce. Das Testing-Tool baut, startet und wertet Tests direkt im Shop aus. So wird jede Vorhersage am echten Ergebnis geprüft. Begleitete Umsetzung heißt: Du baust, prüfst, startest und analysierst die Tests zusammen mit dem DRIP-Team.
In den anderen vier Dimensionen gewinnt Apex hier nicht. Unseren Preis klären wir im Gespräch, er ist nicht veröffentlicht. Wir haben noch kein öffentliches Bewertungsprofil. Unser Script-Gewicht ist nicht veröffentlicht. Und wir hosten in UK (London) und Irland, nicht in der EU. ABlyft und Varify.io bieten hier EU-Hosting. Eine Vorhersage ist außerdem eine Wahrscheinlichkeit, keine Garantie. Unsere Gewinnquote ist die Bilanz unseres Programms, kein Versprechen für einen einzelnen Shop. Wenn dein Team Tests schon gut auswählt, bringt dir die fünfte Dimension wenig. Dann ist ein günstigeres Self-Service-Tool die vernünftige Wahl.
Nutze also das Framework, nicht das Ranking. Bewerte deine Auswahl nach Statistik, Daten, Editor und Preismodell, gemessen an deinen eigenen Bedingungen. Dann stell jedem Anbieter die fünfte Frage: Was im Produkt hilft mir bei der Entscheidung, welche Tests ich starte? Die meisten antworten mit einer Hypothesen-Vorlage. Wir antworten mit 4,3 Millionen früheren Ergebnissen. Miss uns an dieser Antwort genauso streng wie alle anderen.
Deine Testideen bewerten lassen, bevor du sie baust? Prüfen, ob dein Shop passt→